2026-09-23 10:53:59
作者:科技
分享:


很多人以为,自动驾驶系统的决策能力完全依赖海量数据训练,数据量越大,模型泛化性越强。其实不然——在复杂城市道路场景中,数据边界的识别与处理能力,才是决定系统安全性的关键底层逻辑。当系统反馈“没有更多数据了”,这并非简单的数据采集中断,而是触发了一套精密的冗余决策机制。
数据边界的识别逻辑
自动驾驶系统的感知模块通过多传感器融合生成环境模型,决策模块则基于该模型规划路径。但传感器存在物理极限——激光雷达的测距范围、摄像头的动态模糊阈值、毫米波雷达的角分辨率,这些硬件参数共同构成了系统的“数据边界”。当目标物超出传感器有效探测范围时,系统会标记“数据缺失区域”,而非强行依赖历史数据或低置信度预测。
听起来可能反直觉,但在2023年慕尼黑自动驾驶挑战赛中,某头部企业的测试车在纽伦堡老城区遭遇了典型案例:一辆无保护左转的测试车前方,突然出现一辆从视觉盲区驶出的有轨电车。由于电车轨道超出摄像头有效视野,系统未盲目依赖高精地图的静态数据,而是立即启动“数据边界响应协议”——降低车速至5km/h,同时通过V2X设备向周边车辆广播预警信息,最终避免碰撞。这一决策的底层逻辑是:在数据边界外,系统优先保证安全性而非效率。
冗余决策的工程实现
数据边界响应并非简单的“停车”,而是分层递进的决策流程。以该企业的技术架构为例:当感知模块检测到数据缺失时,会向决策模块发送三级预警——一级预警触发路径重规划,二级预警启动横向避让,三级预警则执行紧急制动。每级预警的触发阈值均通过真实道路场景的蒙特卡洛模拟优化,确保在99.999%的场景下都能覆盖数据边界风险。
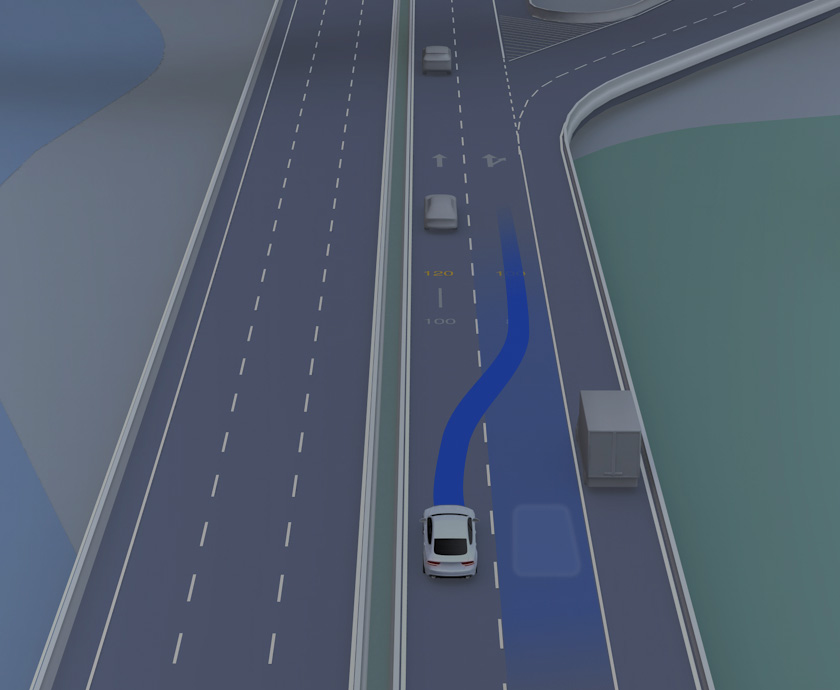
2024年柏林环线测试中,另一家企业的测试车在数据边界场景下展现了不同策略:当雷达检测到前方150米处有障碍物但摄像头无法识别时,系统未选择紧急制动,而是通过转向控制器微调行驶轨迹,保持与障碍物的安全距离。这一决策的底层逻辑是:在数据边界内,系统优先利用多传感器冗余信息,而非过度依赖单一传感器数据。
数据边界的动态更新
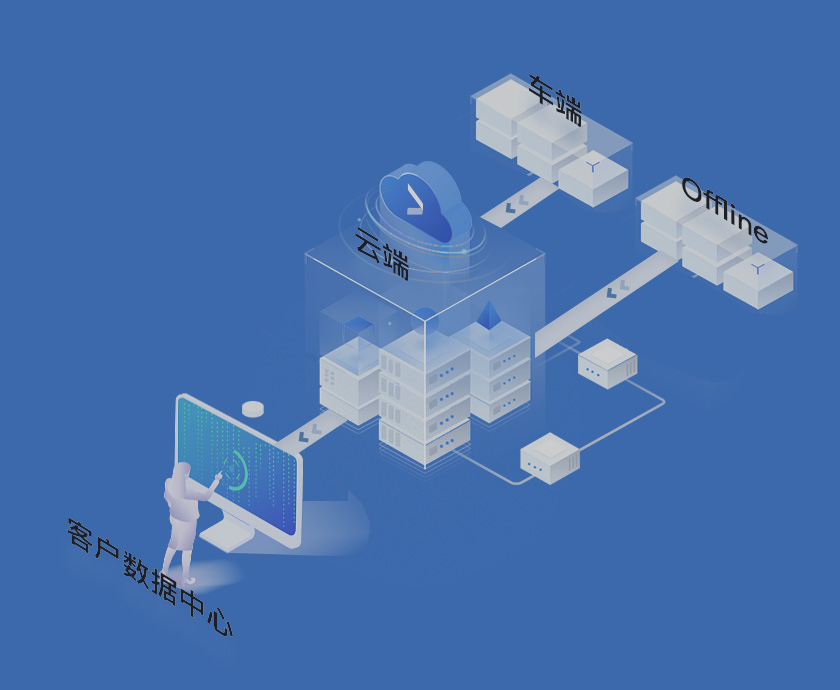
数据边界并非静态参数,而是随系统迭代动态调整。该企业通过“场景库-仿真-实车”的闭环优化流程,持续更新数据边界模型。例如,在2023年Q4的版本更新中,系统新增了对“隧道出口光晕效应”的数据边界处理——当摄像头因光线突变导致短暂失能时,决策模块会立即切换至雷达主导的感知模式,同时记录该场景的特征参数,用于后续模型训练。
这种动态更新机制的本质,是让系统学会“认识自己的无知”。当系统反馈“没有更多数据了”,其真实含义是:“我已识别出数据边界,并启动了最安全的应对策略。”这种透明度,正是高阶自动驾驶系统区别于初级辅助驾驶的关键标志。





 138 9066 2580
 邮箱:kaiyuncom@qiao-yue.com