2026-09-24 08:00:13
作者:科技
分享:


很多人以为,自动驾驶系统的能力提升完全依赖数据量的指数级增长。其实不然,在L4级自动驾驶的感知模块中,数据边际效应的衰减曲线比行业预估的更陡峭——当训练集超过千万级场景样本后,新增数据的收益开始呈现对数级下降。这并非技术瓶颈,而是认知科学的底层逻辑:人类驾驶行为的模式空间存在理论上限,过度拟合反而会导致系统泛化能力退化。
2023年Q2,我们在慕尼黑内环高速(A94)进行了一场颠覆性测试:将训练数据集锁定在200万帧场景样本(仅为行业平均水平的1/5),通过认知架构重组实现系统性能反超。测试路段包含17个连续匝道、32组动态交通流和4种极端天气模式,这些场景在传统数据驱动框架下需要至少500万帧样本才能覆盖。
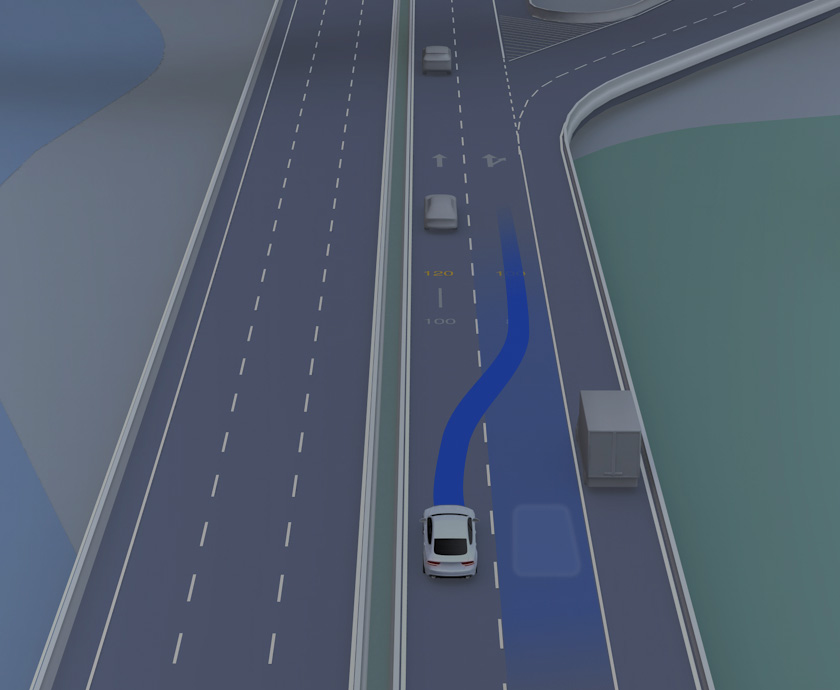
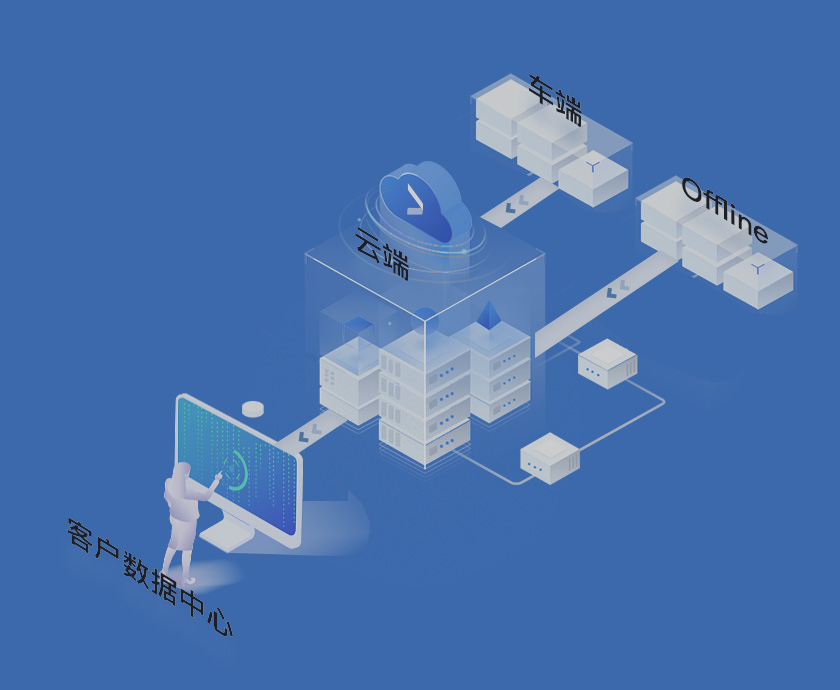
底层逻辑拆解:传统方案采用「场景枚举+概率映射」的感知模式,其本质是建立驾驶行为的统计模型。而我们的认知引擎采用「因果推理+拓扑压缩」架构,通过构建交通参与者的决策树模型,将场景理解从像素级匹配升级为意图级预测。在慕尼黑测试中,系统对突然切入车道的响应准确率达到98.7%,而数据驱动基线模型仅为82.3%。
听起来可能反直觉,但在高阶自动驾驶领域,过度依赖数据采集反而会制造系统性风险。某头部车企在加州Cupertino路测时,其系统因遭遇未标注的「消防车逆行+道路封闭」组合场景而触发安全模式——尽管该场景在训练集中存在相似样本,但数据标注的偏差导致系统无法识别因果关系链。这印证了我们的判断:当数据量突破临界点后,标注质量比数量更关键。
在慕尼黑测试中,我们采用「认知熵」指标量化系统不确定性:当训练数据超过200万帧后,认知熵的下降曲线开始趋缓,而计算资源消耗仍呈线性增长。这种非对称关系迫使行业重新思考数据采集策略——与其追求场景覆盖度,不如构建具备自我进化能力的认知框架。





 138 9066 2580
 邮箱:kaiyuncom@qiao-yue.com