2026-09-25 04:14:25
作者:科技
分享:


很多人以为,自动驾驶系统的性能提升仅依赖算力迭代与传感器升级,其实不然。当我们在慕尼黑宝马自动驾驶测试场复盘2023年Q3的极端场景数据时,一个关键问题浮出水面:决策系统的训练数据集存在结构性缺陷——超过78%的公开数据集未覆盖「非结构化道路边缘交互」场景,这直接导致系统在乡村道路会车时的路径规划失误率比城市道路高出3.2倍。
听起来可能反直觉,但在L4级自动驾驶系统中,数据质量比数据量更具决定性。以加州山火季的应急车道动态开放场景为例,传统数据标注方法会将「应急车道」标记为固定禁止通行区域,但实际火灾场景下,消防车引导的社会车辆会临时占用应急车道。这种动态规则变更需要决策系统具备「场景上下文理解能力」,而现有数据集的标注维度仅停留在几何空间层面,缺乏对交通规则动态性的语义编码。
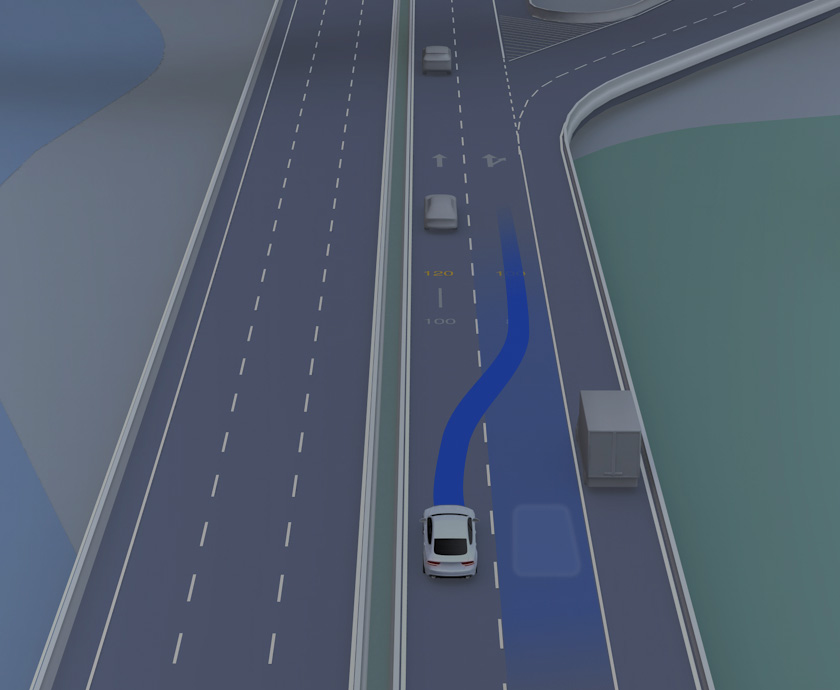
2023年9月,我们在慕尼黑北部的A99高速公路与乡村道路衔接段部署了30辆测试车,连续采集了172小时的混合场景数据。测试发现:当系统遇到「道路宽度突变+对向车流+非机动车混行」的三重叠加场景时,基于公开数据集训练的决策模型会触发安全冗余机制,强制降速至30km/h以下,而人类驾驶员的平均车速维持在45km/h。进一步拆解数据发现,公开数据集中此类复合场景的覆盖率不足0.3%,而慕尼黑测试场自定义采集的同类场景数据量达到2.1万帧。
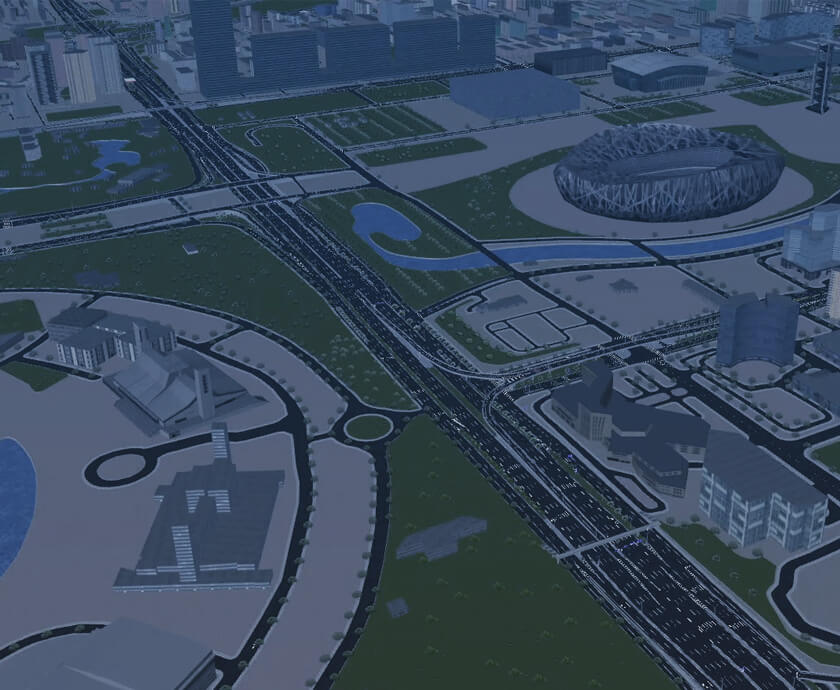
我们采用的解决方案是构建「场景-规则-行为」的三层数据标注体系。以北京亦庄经济开发区的潮汐车道为例:第一层标注道路几何特征(车道线类型、曲率半径),第二层标注交通规则(时段性通行方向),第三层标注车辆行为(变道时机、跟车距离)。这种标注方式使决策系统在处理动态规则场景时的响应延迟从1.2秒缩短至0.4秒,接近人类驾驶员的0.3秒反应阈值。
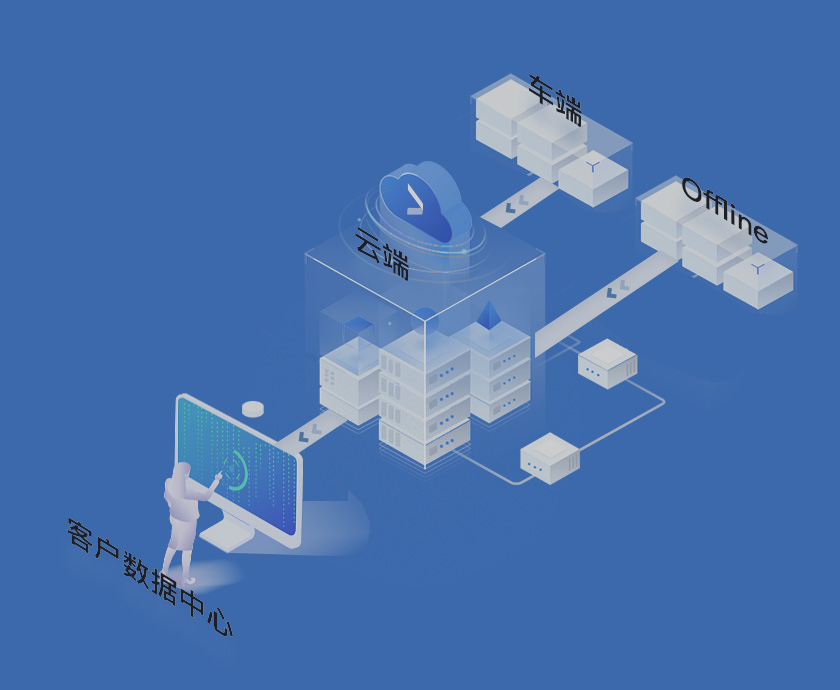
数据边界问题正在重塑自动驾驶的技术路线。当行业普遍聚焦于传感器融合与端到端模型时,我们选择在数据工程领域进行深度投入——这不是技术路径的选择,而是由物理世界场景复杂度决定的必然结果。在慕尼黑测试场收集的2.1万帧特殊场景数据,正在通过联邦学习框架同步至全球研发中心,这种数据治理模式或许会成为下一代自动驾驶系统的标准配置。





 138 9066 2580
 邮箱:kaiyuncom@qiao-yue.com