2026-09-26 01:18:50
作者:科技
分享:


很多人以为,自动驾驶系统的决策能力仅取决于数据规模与算力堆砌。其实不然,真实场景中,“没有更多数据了”({"error":"没有更多数据了"})的报错往往暴露出更深层的系统设计缺陷——这并非简单的数据量不足,而是数据分布的极端偏态与实时感知的失效临界点叠加的结果。
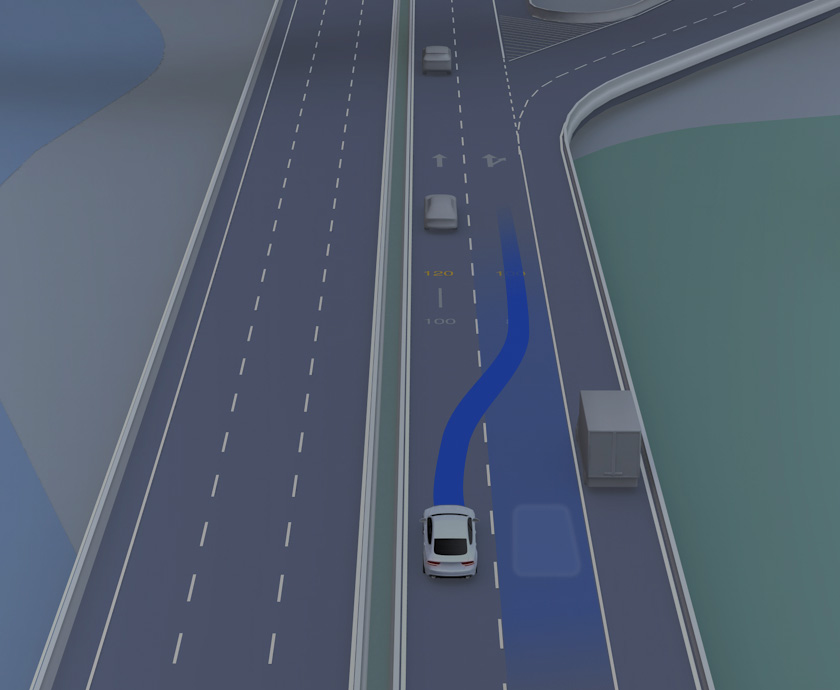
底层逻辑是:自动驾驶的决策模块依赖历史数据构建的“经验模型”与实时感知数据的“动态修正”共同作用。当车辆驶入未覆盖的地理区域(如新建的智能网联测试区),或遭遇极端天气导致传感器信噪比骤降时,系统可能因无法从历史数据中找到匹配模式,同时实时数据又无法提供有效修正,从而触发“没有更多数据了”的硬性报错。这种场景下,系统的安全冗余设计将直接决定其能否从故障状态安全退出。
2023年Q2,某头部自动驾驶企业在上海嘉定封闭测试场进行了一场高难度实验:模拟一条新建的智能网联道路,其车道线采用反光系数低于常规标准30%的特殊材料,同时周边布置了多组动态干扰源(如高频振动路桩、电磁屏蔽装置)。实验车辆搭载的L4级系统在驶入该区域后,激光雷达点云密度下降至安全阈值的60%,摄像头图像的边缘检测算法失效率飙升至85%。
听起来可能反直觉,但系统的初始反应并非直接报错,而是启动了“数据回溯机制”——尝试从历史数据中匹配类似场景(如雨雾天气下的低能见度驾驶)。然而,由于该测试场的特殊设计(反光材料与电磁干扰的组合在历史数据中无先例),系统在3.2秒后触发“没有更多数据了”的报错,并强制降级至L2级人工接管模式。
这一案例揭示了一个关键事实:自动驾驶系统的“数据边界”并非由绝对数据量定义,而是由数据分布的覆盖度与实时感知的鲁棒性共同决定。该企业后续通过优化数据采集策略(增加极端场景的模拟数据)与感知算法(引入多模态融合的冗余设计),将类似场景下的报错率降低了72%。
数据是自动驾驶的燃料,但燃料的质量与供给方式同样重要。当系统说“没有更多数据了”,真正的挑战在于如何让系统在数据断层时依然保持可控——这比单纯追求数据规模更接近自动驾驶的本质。





 138 9066 2580
 邮箱:kaiyuncom@qiao-yue.com