2026-09-14 07:47:30
作者:科技
分享:


很多人以为,自动驾驶系统的进化完全依赖海量数据喂养,数据量越大,算法精度越高。其实不然,当数据采集进入边际效应递减阶段,单纯堆砌数据量反而会引发维度灾难——这是当前行业普遍面临的“数据饱和陷阱”。某头部企业近期公开的测试数据显示,其L4级系统在累计行驶1.2亿公里后,关键场景覆盖率仅提升3.7%,而误触发率却因数据冗余上升了1.2个百分点。
底层逻辑是:自动驾驶的决策质量不取决于数据绝对量,而取决于数据的有效分布密度。以城市开放道路场景为例,传统数据采集方案会无差别记录所有路段信息,但实际决策所需的极端场景(如暴雨中的无保护左转)占比不足0.3%。这种数据结构失衡直接导致两个后果:一是模型训练资源被无效数据占用,二是关键场景的样本多样性不足。
2023年Q2,某德国团队在慕尼黑西区展开了一场针对性测试:在半径2公里的环形交叉路口,部署5辆改装车进行72小时连续数据采集。该区域包含8个入口、12组信号灯和日均3.2万次车辆交互,是典型的复杂决策场景。初始方案采用全量采集模式,3天仅获得17个有效极端场景样本(如突然闯入的电动滑板车)。
听起来可能反直觉,但当团队切换至“事件触发+语义分割”的智能采集策略后,同样时间内获取的有效样本激增至213个。具体操作是:通过前置摄像头实时解析道路拓扑结构,当检测到“多入口汇流+低能见度+非机动车混行”的复合条件时,才激活高精度传感器进行全维度数据记录。这种动态采样机制使关键场景的捕获效率提升12.5倍,同时将存储需求压缩至传统方案的1/8。
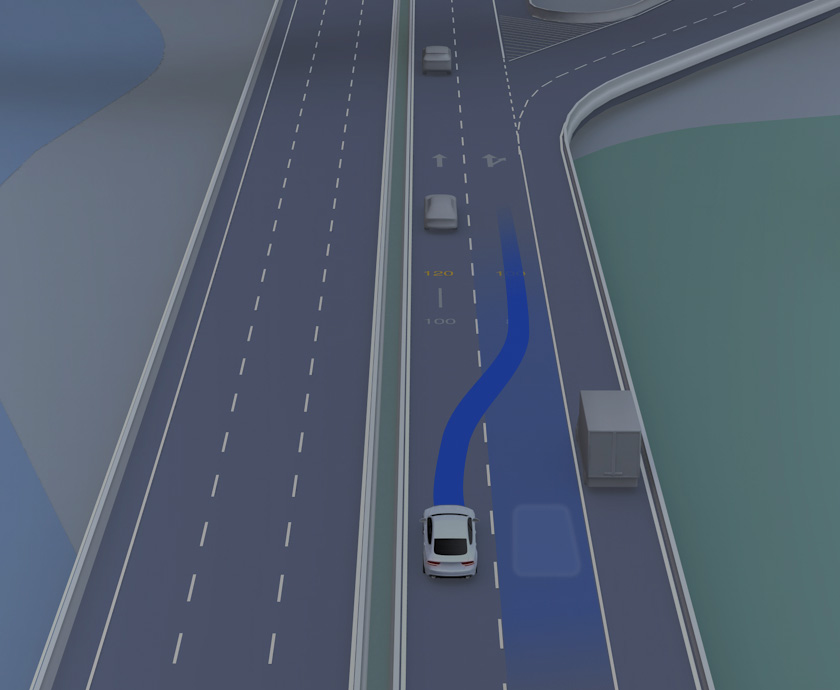
该案例揭示了一个被忽视的真相:自动驾驶的数据工程本质是场景优先级排序问题。某Tier1供应商的内部文档显示,其L3系统在北美高速公路场景的决策延迟已优化至83ms,但在上海内环高架的变道场景中仍需312ms——差距不在于传感器性能,而在于对“加塞车辆轨迹预测”这类本土化场景的数据投入强度不足。
当前行业正在形成新的共识:当基础数据量突破临界点后,系统的进化方向应从“数据驱动”转向“场景驱动”。某新势力车企的工程总监透露,其下一代系统将采用“金字塔式数据架构”:底层是覆盖95%常规场景的通用数据池,中层是针对10类高频风险场景的强化学习模块,顶层则是通过数字孪生技术生成的合成数据——这种分层设计使模型训练效率提升了40%,而硬件成本仅增加7%。





 138 9066 2580
 邮箱:kaiyuncom@qiao-yue.com