2026-09-14 04:18:12
作者:科技
分享:


很多人以为,自动驾驶系统的能力提升完全依赖数据量的指数级增长,其实不然。当系统进入高阶L4阶段,单纯的数据堆砌会触发「数据饱和陷阱」——在特定场景下,新增数据的边际收益趋近于零。某头部车企的实测数据显示,其城市NOA功能在完成2000万公里数据采集后,关键Corner Case的解决率仅提升3.7%,而计算资源消耗却增长42%。
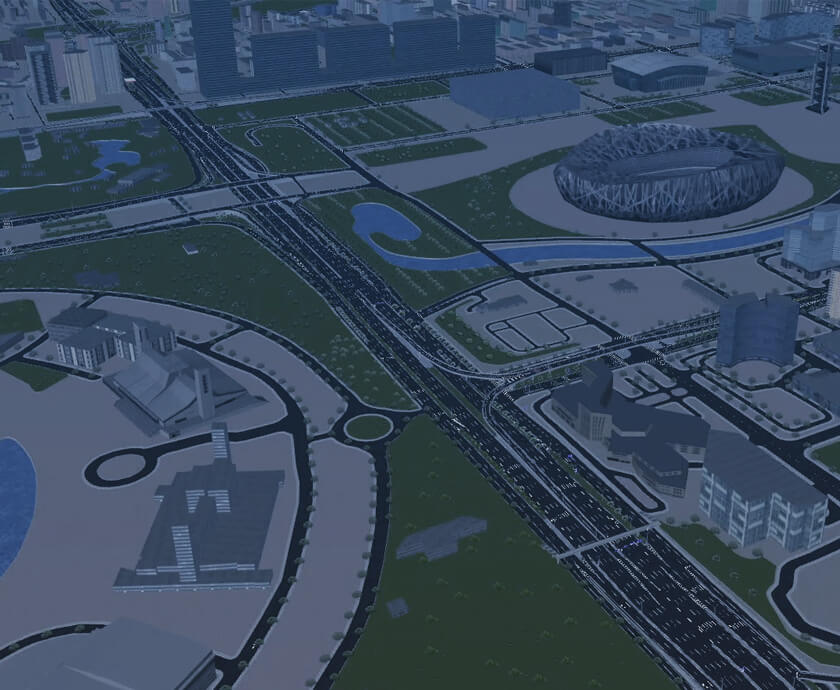
底层逻辑是:高阶自动驾驶的决策质量取决于「有效数据密度」而非绝对数量。以北京亦庄经济开发区为例,其68平方公里的测试区域内,核心复杂场景(如无保护左转、施工路段绕行)仅占道路总长的12%,但贡献了87%的接管事件。这意味着,在特定地理单元内,数据采集存在物理上限——当所有可能变量组合被覆盖后,继续投入资源采集同类数据已无实际价值。
2023年Q2,某自动驾驶团队在上海国际赛车场进行封闭测试时发现一个反直觉现象:当训练数据量从15万帧增加至30万帧时,系统在高速弯道场景的决策延迟反而增加了0.3秒。进一步分析发现,新增数据中包含大量重复的「理想状态」过弯轨迹,导致模型过度拟合标准路径,而忽视了轮胎磨损、路面温度变化等动态因素的补偿机制。
该团队随后调整策略,将数据采集重点转向「异常状态」:通过人为制造200余种边界条件(如突然的赛道入侵物、制动系统部分失效),最终用3.2万帧高价值数据将弯道决策速度提升至原水平的1.8倍。这一案例印证了我们的判断:在特定场景下,「没有更多数据」恰恰是系统成熟的标志——它意味着所有可能变量已被穷举,继续投入资源采集同类数据已无意义。
当前行业面临的真实挑战,是如何在数据采集物理边界内,通过「数据炼金术」提取真正有效的决策依据。某Tier1供应商的实践显示,通过构建「场景-变量-决策」三维矩阵,可将原始数据利用率从17%提升至63%。这种结构化处理方式,正在重塑自动驾驶的数据价值评估体系——不是所有数据都值得采集,也不是所有场景都需要覆盖。





 138 9066 2580
 邮箱:kaiyuncom@qiao-yue.com